データエンジニア、アナリティクスエンジニアが整備するデータ基盤は、ビジネスメンバー、サイエンティスト、アナリストのデータ利活用をスムーズにすることが、
ざっくりとした役割です。
一方で、その役割はビジネスのオペレーションをサポートする側面がつよく、
直接的に組織の収益構造に影響するということは、稀なケースなのではないかと思います。
そんな中で、<strong>レベニューオペレーション(RevOps)</strong>の概念を知り、
これは、データエンジニアがビジネスで価値を出していくためのヒントになるのでは?
と感じたため、今回はレベニューオペレーション(RevOps)の考えにそって、
組織の収益成長に寄与するデータ基盤の役割とは何か
を妄想していきたいと思います。
https://x.com/ikki_mz/status/1851427194389872765
レベニューオペレーション(RevOps)の教科書 部門間のデータ連携を図り収益を最大化する米国発の新常識(MarkeZine BOOKS)(川上 エリカ / 丸井 達郎 / 廣崎 依久 著、翔泳社)
RevOpsとは
そもそも、RevOpsとは、
持続的な収益成長を実現するために、組織の協業プロセスを強化し、生産性を向上を支援する方法論や役割
と書かれています。
つまり、各部門の連携をスムーズにして、組織全体の収益成長を目指すための仕組みともいえるかもしれません。
各部門とは、特にマーケティング・インサイドセールス・営業・カスタマーサクセスなどの収益関連部門を指すことが多いです。
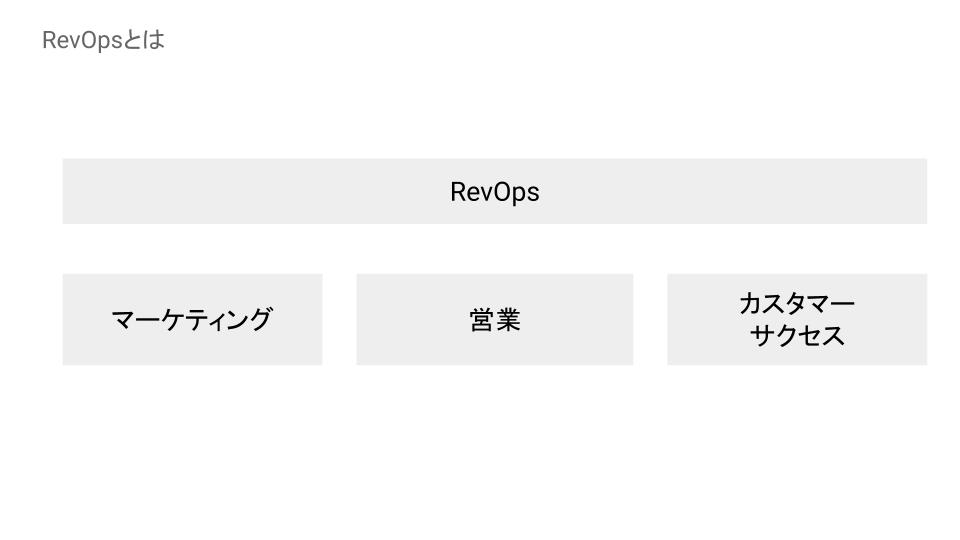
RevOpsと比較されているのが、機能別組織です。
機能別組織とは、各部門の責任範囲を切り分けた分業型の組織体制であり、
メジャーな組織体制ですが、部門のサイロ化という弊害がでる可能性があります。
機能別組織の弊害
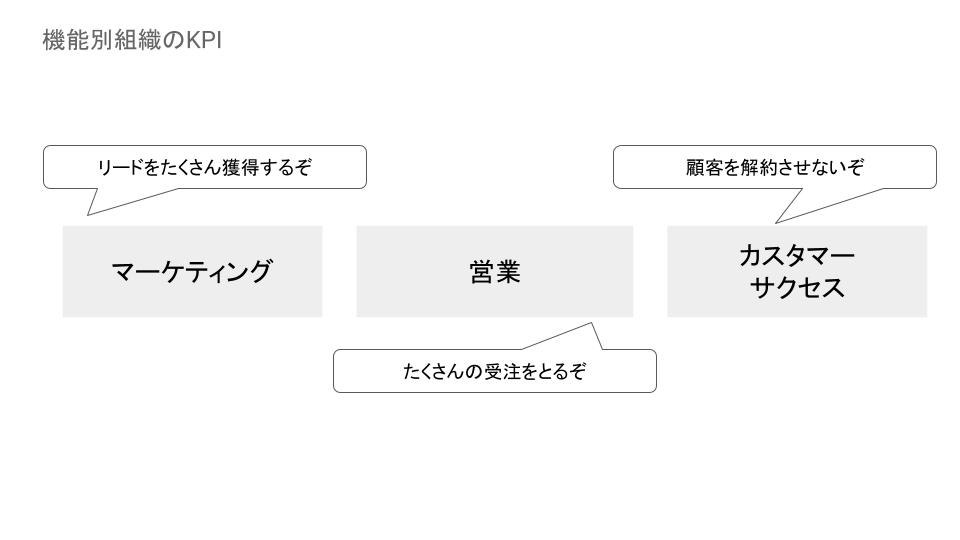
機能別組織は、それぞれの部門ごとにKPIを設定し、その達成に責任をもちます。
例えば、以下のような感じ
いっけんすると違和感のない組織体制ですが、
部門のサイロ化を生み、結果的に組織の持続的な成長ができなくなることがあります。
例えば、マーケティングは、リードの数が重要なので、たくさんのリードを獲得してきます。
営業は、受注件数が重要なので、サービスとの相性関係なく受注を獲得します。
すると、カスタマーサクセスは、様々なロイヤリティをもつ顧客の解約防止にたくさんのリソースがとられてしまいます。
結果的に、短期的な売上はのびても、長期的に売上をのばすことができない構造になっています。
RevOpsの役割
ここで、RevOpsの出番です。
RevOpsでは、収益プロセスにおける部門の役割を明確化し、リード獲得から受注にいたるまでのオペレーションルールを確立させます。
また、各部門で組織の収益に寄与するKPIの合意をとり、それを組織全体の共通認識としていきます。
例えば、マーケティングが、単純なリードの数ではなく、
「獲得したリードの顧客転換率」をKPIとすることで、マーケティングと営業が共通の目標を持って動くことができます。
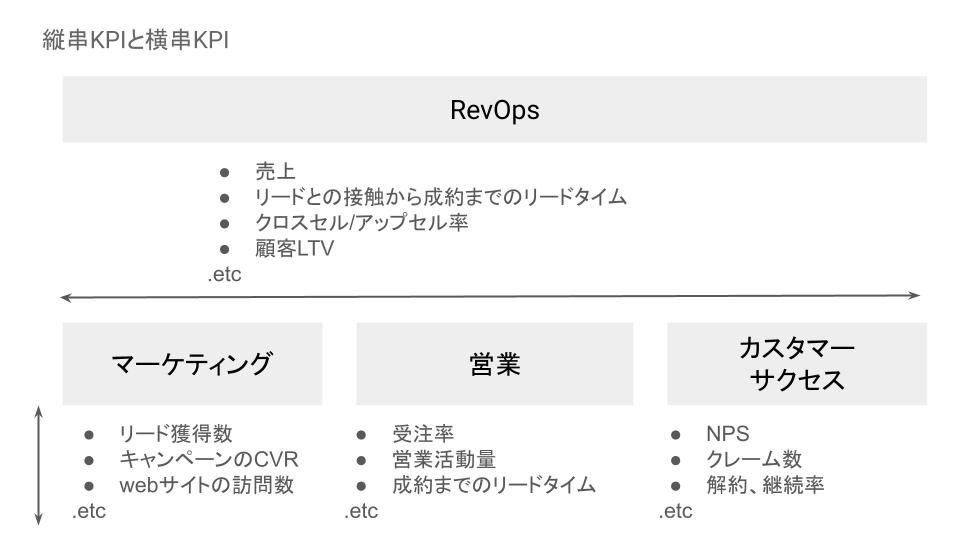
機能別組織がそれぞれの部門で縦串のKPIを持つのに対し、
RevOpsでは、各部門のKPIを横串でつなげて、一貫した顧客体験の提供と企業全体の収益成長にフォーカスする
ことができます。
RevOpsにおけるデータ基盤の要件と実装
前置きがながくなりました。タイトルのアンサーは、
RevOpsに貢献するデータ基盤こそが、収益成長に貢献するデータ基盤であるということになります。
では、ここからは完全に私の妄想で、データ基盤に必要とされる要件とその実現方法を考えてみます。
横串KPIとSSOT(Single Source of Truth)
RevOpsでは、各部門がもつKPIを網羅的に算出できるだけでなく、
各KPIの間を横串でつなげられることが重要です。
例えば、獲得したリードの中で、どれぐらいが受注につながったのか?、
リード獲得から売上が発生するまでのリードタイムはどれぐらいか?
などです。
あわせて、各部門が一つの共通目標をもつためには、データが<strong>SSOT(雄一信頼できる情報源)</strong>である必要もあります。
収益全体を表す指標から、ドリルダウンした各部門のKPIまでを一貫させておき、
どこで切り取ってもKPIが同じロジックで出力される金太郎あめ(少し違うか?)のようなデータであることが重要です。
これらを実現するためには、マーケティング、営業、カスタマーサクセス部門がそれぞれ使用しているツール
の情報を一つのデータウェアハウスに集約することはもちろん、KPI算出ロジックについて各部門と合意をとること、蓄積したデータの品質を担保すること、集計ロジックを一つの場所に集約することなどで実現できると考えています。
リバースETL
RevOpsが現場とオペレーションの連携モデルである以上、単に数値をモニタリングできるだけでは意味がなく、
各ビジネスオペレーションに関与することができるデータ基盤である必要あります。
そのためには、データ基盤に蓄積したデータを再利用して、各部門が使い慣れたツールに返していくリバースETLも必要です。
リバースETLのイメージは、以下のような感じです。
- マーケティングへ:休眠や過去に解約した顧客をリストアップする。
- 営業へ:マーケティングが獲得したリードの一覧を表示させる。
- カスタマーサクセスへ:解約しやすそうな顧客をみつけるため、顧客ごとにスコアリングをする。(ヘルススコア)
KPIの予測精度
RevOpsの重要な要素の一つに、<strong>フォーキャスト(予測)</strong>があります。
これは、KPIの予測があることで、リソースの投資判断を適切なリズムで行うことができるためです。
KPIの予測は、様々なデータを使うことで、予測精度向上が見込まれますので、
顧客のカスタマージャーニーすべてのデータをシームレスにつなげておくことが重要そうです。
また、予測モデルを作るには、データサイエンティストとの連携が必要なので、
データサイエンティストが予測タスクに注力できるようにデータマートを整備したり、
継続的な予測タスクのためのデータライフサイクルを考えたりしながら実装を進めます。
データの民主化
さいごに、RevOpsを成功させるには、各部門がデータドリブン、もしくは、データインフォームドな意思決定をする文化が必要です。
そのためには、データカタログの整備、SQLをつかったアドホック解析のレクチャー、ビジネスロジックを反映したデータモデリングなどを通して、
データを広く開放します。
データチームがダッシュボードやリバースETLで情報を提供するだけでなく、各部門担当者が情報をドリルダウンできる環境を整備することで、
データをもとに意思決定をする文化が根付いていくと考えています。
さいごに
RevOpsにおいては、データを集約し、部門をまたいだデータ基盤を作成することが必須条件になります。データチームは、もともと組織横断的に動くことも多いと思いますので、
RevOpsとの相性はよいのでは?と思っています。
本書では、RevOpsについての更に詳しい内容や、そもそもRevOpsを推進するためにはどこから手を付けるべきか?などが記載されているので、ぜひともてにとってみてください。
データ分析基盤の直接的なビジネス的価値については、
まだまだ議論の余地がありそうですので、今後も考え続けて行きたいと思います。
※本記事は筆者が個人的に学んだこと感じたことをまとめた記事になります。所属する組織の意見・見解とは無関係です。
ご参考
https://stable.co.jp/blog/bizops-data-quality